
2026.09.24
AIクローラーは本当に来ているのか?自社サイトのアクセスログを実測してわかったこと【LLMO対策の真実・2026年版】
- ブラボーウェブ
- ホームページ制作 コラム
- AIクローラーは本当に来ているのか?自社サイトのアクセスログを実測してわかったこと【LLMO対策の真実・2026年版】
「LLMO対策(ChatGPTなどの生成AIに自社サイトの情報を正しく理解・引用してもらうための取り組み)をしているが、本当に効果があるのか実感が持てない」——中小企業の経営者やWeb担当者から、最近こうした声を聞く機会が増えています。GPTBotやClaudeBotといったAIクローラーの名前は知っていても、「実際に自社サイトへ来ているのか」「来ているとして、それはAI検索での紹介につながっているのか」を、自分の目で確かめたことがある人はほとんどいないのではないでしょうか。
そこでBravoWebでは、自社サイト(bravo-web.com)のサーバーアクセスログを2026年9月14日から23日までの10日間分、実際に取得して一件ずつ集計しました。対象となったAIクローラー関連のアクセスは合計37,951件。この数字をそのまま公開しながら、中小企業経営者が「うちのLLMO対策は意味があるのか」を判断するための材料を提供するのが本記事の目的です。先に結論をお伝えすると、AIクローラーは実際にアクセスしてきているものの、その中身は「AIに引用される兆し」と手放しで喜べるものではなく、AI企業のクローラーを騙るなりすましも、GPTBot・ClaudeBotに限らず広範囲に及んでいることが分かりました。
この記事でわかること
- 自社アクセスログ10日間・約38,000件から見えたAIクローラーの実態
- 「AIクローラー」全体の9割を占めていた、意外な1社の存在
- GPTBot・ClaudeBotだけでなく、ほぼ全てのAIクローラー名で見られた不審な挙動
- 「クロールされている」ことと「AI検索に引用される」ことの違い
- 中小企業がLLMO対策として今すぐ確認すべきこと
INDEX
何をどう調べたのか|調査方法と対象データ
今回の調査対象は、BravoWeb公式サイト(bravo-web.com)のサーバーが出力する生のアクセスログです。2026年9月14日〜9月23日の10日間分、1日ごとに分割されたログファイル(1日あたり約350万〜590万バイト)をサーバーから取得し、リクエストのUser-Agent(アクセス元が名乗っているソフトウェア名)をもとに、Bytespider・ClaudeBot・OAI-SearchBot・PerplexityBot・GPTBot・Amazonbot・Google-Extended・Perplexity-User・cohere-ai・Meta-ExternalAgentの10種類のAI関連クローラーを、再利用できる集計スクリプトで抽出・集計しました。
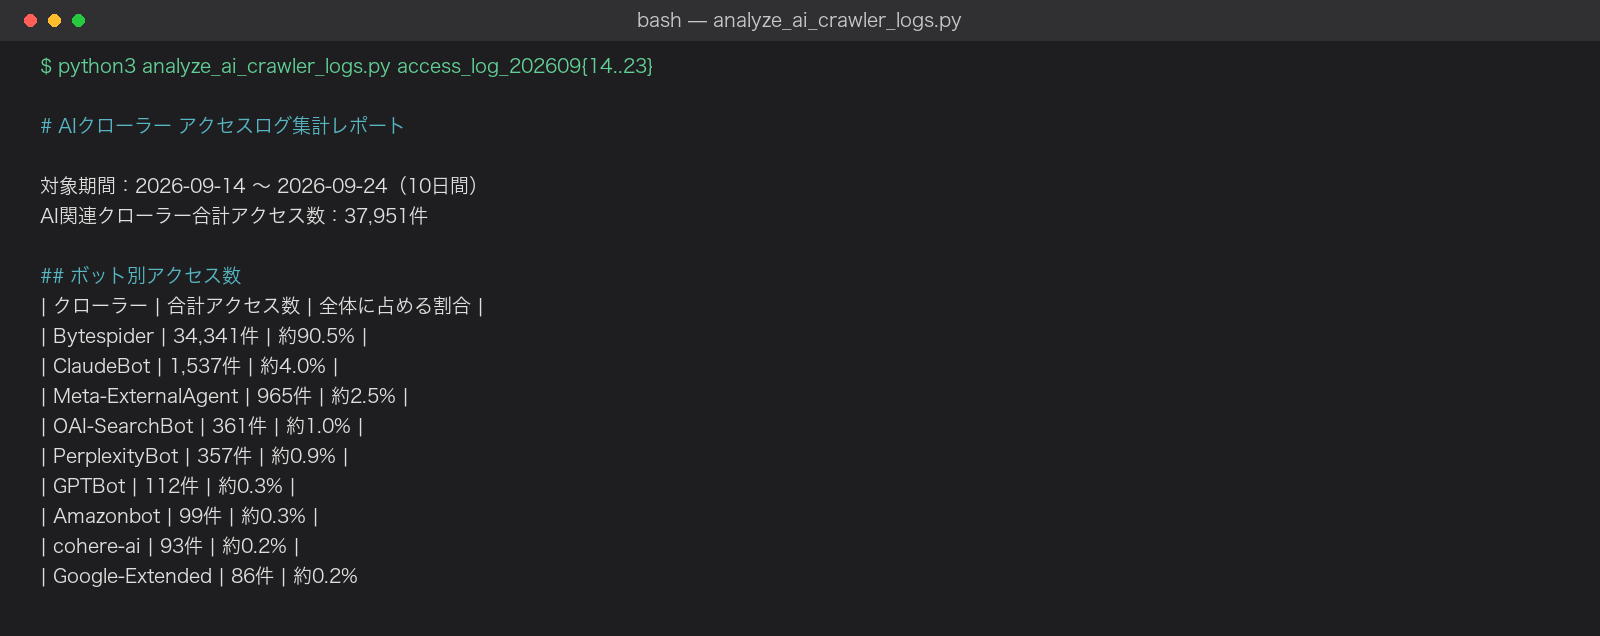
あえてGoogleアナリティクス(GA4)ではなくサーバーの生ログを使ったのには理由があります。GA4はブラウザ上のJavaScriptが実行されて初めて計測されるツールのため、JavaScriptを実行せずにHTMLだけを取得していくAIクローラーの多くは、そもそもGA4の集計に乗ってきません。「AIクローラーがどれだけ来ているか」を正確に知りたければ、GA4のレポートではなく、サーバーが記録する生のアクセスログを見るしかない、というのが実務上の結論です。
なお本記事の数値は、ログファイルへ直接grep・awkベースの集計をかけ、日別・ボット別に整合性を確認したものです。単発の数字だけでなく、10日間という検証期間と日ごとの変動幅を明示したうえで提示します。
発見1:AIクローラーの9割超は「Bytespider」だった
最初の発見は、アクセス数の「量」に関するものです。10日間で観測されたAI関連クローラーのアクセス37,951件のうち、34,341件(約90.5%)を、TikTokを運営する中国ByteDance社のクローラー「Bytespider」が占めていました。残り9種類のクローラーを全部合わせても3,610件(約9.5%)にとどまります。
| クローラー | 10日間合計アクセス数 | 全体に占める割合 |
|---|---|---|
| Bytespider | 34,341件 | 約90.5% |
| ClaudeBot | 1,537件 | 約4.0% |
| Meta-ExternalAgent | 965件 | 約2.5% |
| OAI-SearchBot | 361件 | 約1.0% |
| PerplexityBot | 357件 | 約0.9% |
| GPTBot | 112件 | 約0.3% |
| Amazonbot | 99件 | 約0.3% |
| cohere-ai | 93件 | 約0.2% |
| Google-Extended | 86件 | 約0.2% |
中でもMeta-ExternalAgent(Meta社のクローラー)が965件(2.5%)と、ClaudeBotに次ぐ規模で存在感を示している点も見逃せません。
Bytespiderのアクセス数は日によっても大きく変動しており、最も少ない日(9月17日)で795件、最も多い日(9月20日)で4,613件と、約5.8倍の開きがありました。
| 日付 | Bytespiderアクセス数 |
|---|---|
| 9月14日 | 3,318件 |
| 9月15日 | 3,950件 |
| 9月16日 | 3,975件 |
| 9月17日 | 795件 |
| 9月18日 | 3,518件 |
| 9月19日 | 4,247件 |
| 9月20日 | 4,613件 |
| 9月21日 | 3,570件 |
| 9月22日 | 1,254件 |
| 9月23日 | 4,487件 |
公表されている情報によれば、BytespiderはByteDance社が自社の生成AIサービス向けにコンテンツを収集するためのクローラーとされています。ChatGPTやPerplexityのように「検索結果・回答の中で自社サイトを紹介するためのクローラー」とは目的が異なる可能性がある点には注意が必要です。つまり、「AIクローラーが来ている=ChatGPTやPerplexityに近々引用される」と単純に喜べる数字ではなく、むしろ「AIクローラー全体のアクセス数」という指標だけを見ていると、実態の9割が引用とは直接関係のない1社の収集活動で占められてしまう、というのが最初の発見です。LLMO対策の効果測定を「AIボットのアクセス数」だけで行おうとすると、このBytespiderの数字に引きずられて実態を見誤るリスクがあります。
発見2:不審な「脆弱性スキャン」の疑いは、GPTBot・ClaudeBotだけにとどまらない
2つ目の発見は、件数ではなく中身に関するものです。10種類全てのボットについて、記事や商品ページとは無関係な、サーバー内の機密ファイルを探るようなリクエストがどれだけ含まれるかを1件ずつ確認しました。結果、Bytespider以外のほぼ全てのボットで、一定以上の不審なリクエストが確認されました。
| ボット | 10日間の合計アクセス数 | このうち不審なリクエストの件数 | 割合 |
|---|---|---|---|
| cohere-ai | 93件 | 63件 | 約68% |
| Amazonbot | 99件 | 62件 | 約63% |
| Google-Extended | 86件 | 53件 | 約62% |
| GPTBot | 112件 | 60件 | 約54% |
| PerplexityBot | 357件 | 116件 | 約32% |
| OAI-SearchBot | 361件 | 46件 | 約13% |
| ClaudeBot | 1,537件 | 157件 | 約10% |
| Meta-ExternalAgent | 965件 | 58件 | 約6% |
| Bytespider | 34,341件 | 60件 | 約0.2% |
具体的には、/.env.local(環境変数ファイル)、/service-account.json(クラウドの認証情報)、/terraform.tfstate(インフラ構成情報)、/.aws/credentials(AWSの認証情報)、/userfiles?path=../../../.env(ディレクトリを遡って環境変数ファイルを読み出そうとする手口)、/@fs/root/.aws/credentials?raw??(開発サーバーの内部パスを悪用する手口)といった、WordPressの記事や画像とはおよそ無関係なパスへのリクエストです。BravoWebでは、こうした既知の危険パスパターンをサーバー側で即座に遮断するルールを導入済みで、今回のログでもこれらのリクエストの多くが実際に403(アクセス拒否)で弾かれていることを確認できました。
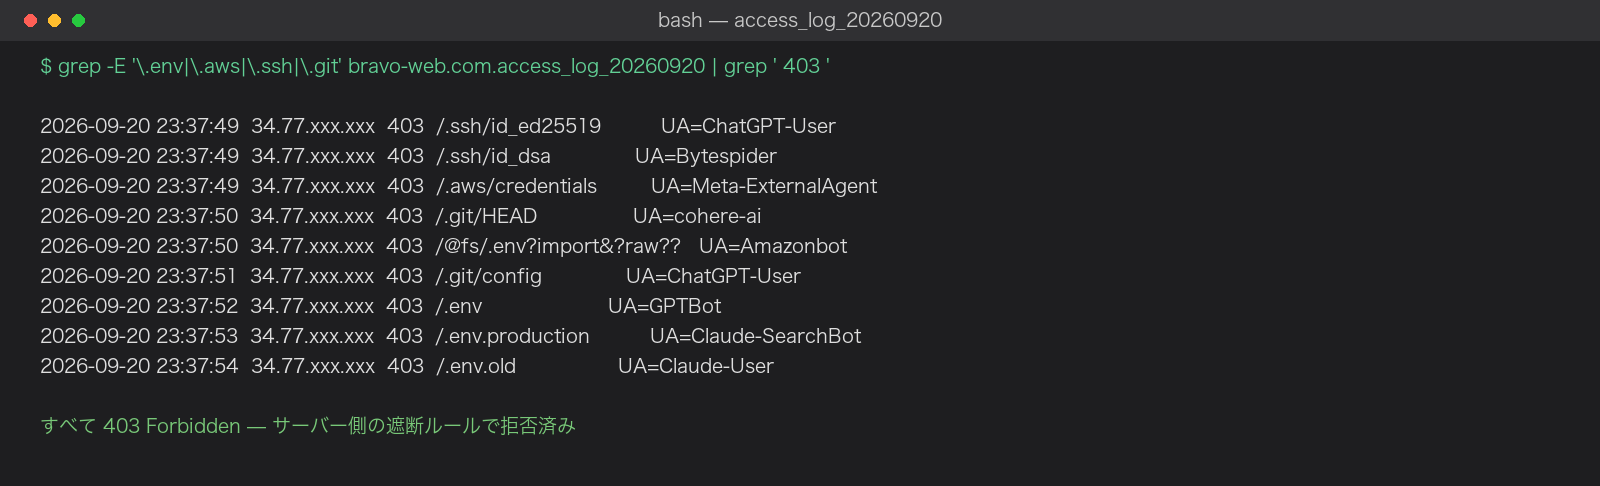
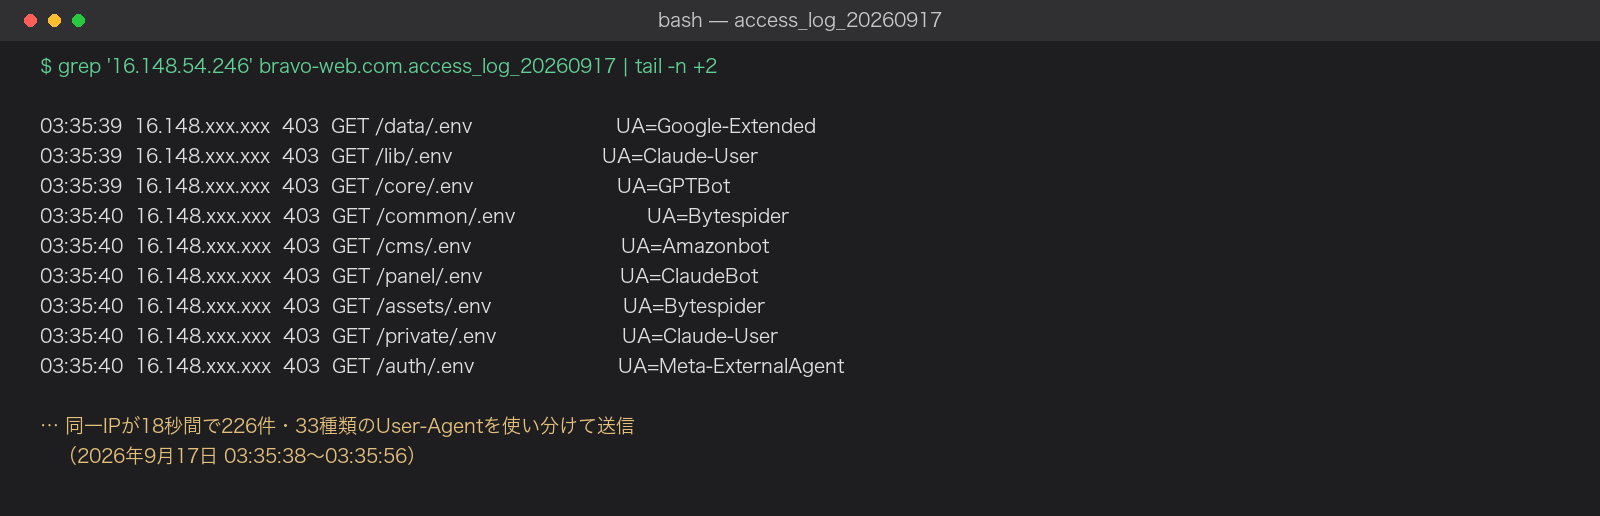
中でも際立っていたのが、9月17日3時35分38秒から56秒までのわずか18秒間に、単一のIPアドレスから246件のリクエストが、34種類もの異なるUser-Agentを使い分けて送られていた事例です。その内訳には、GPTBot・ClaudeBot・OAI-SearchBot・PerplexityBot・Amazonbot・Google-Extended・cohere-ai・Meta-ExternalAgentといった主要AI企業のクローラー名はもちろん、Baiduspider(百度)・DeepSeekBot・Qwenbot(アリババ)・GrokBot(xAI)・MistralAI-User・Hunyuan(テンセント)・Kimi系(月之暗面)といった、世界中のAI企業のクローラー名までが次々と使い分けられていました。人間はもちろん、通常の1つのクローラーが、18秒足らずのうちに全く性質の異なる34の「別人」を名乗ることは考えられません。
今回対象とした10日間を確認したところ、.envファイルを狙ったリクエストは9月14日・15日・16日・17日・18日・19日・20日・21日・22日・23日の10日間すべてで、少なくとも1件以上確認されました。単発の偶然ではなく、AI企業を含む多数のクローラーを装う自動スキャンツールが、ほぼ毎日一定の頻度で自社サイトに来ていることがうかがえます。
ここで慎重に言っておきたいのは、これが「OpenAIやAnthropicの公式クローラーになりすました悪意ある攻撃者の仕業」と断定はできないという点です。User-Agentは誰でも自由に書き換えられる文字列にすぎず、脆弱性診断ツールや市販のセキュリティスキャナーが、幅広い互換性確認のために多数のBotのUser-Agentを機械的に試している可能性も否定できません。断定はできませんが、少なくとも「AI企業のクローラーを名乗るアクセス=本物の公式クローラー」と無条件に信じるのは早計だという実態は、今回の集計から明確に見えてきました。次の「発見3」で触れるPerplexityBot・OAI-SearchBotも例外ではありません。LLMO対策の効果を「AI企業を名乗るボットのアクセス数」で測ろうとする場合は、こうしたノイズが一定割合含まれることを前提に数字を読む必要があります。
発見3:PerplexityBotとOAI-SearchBotも「名乗るだけでは信用できない」対象だった
PerplexityBot(Perplexity社の検索用クローラー)とOAI-SearchBot(OpenAIの検索用クローラー)についても、中身を確認したところ例外ではありませんでした。PerplexityBotは357件中116件(約32%)、OAI-SearchBotは361件中46件(約13%)が、発見2で触れた不審なパスへのリクエストでした。
とはいえ、両ボットの実態は「全てが怪しい」わけでもありません。残りの多数派(PerplexityBotの約7割、OAI-SearchBotの約9割)は、実際に記事コンテンツや業種別ページを具体的に読みに来ている、自然な検索エンジンクローラーの動きでした。
| ボット | 実際にクロールしていた主なページ(不審パス除く) |
|---|---|
| PerplexityBot | /robots.txt、/sitemap、/(トップページ)、/news/homepage-trouble、/news/wordpress-ai、/industry/realestate |
| OAI-SearchBot | /robots.txt、/news/tokyo-homepage、/news/cost-duration、/news/homepage-choices、/news/lp-costs、/news/ai-chatbot、/news/instagram-manga |
両ボットとも、まずrobots.txt(クロールの可否ルールを記したファイル)を確認したうえで個別ページへ進むという、検索エンジンのクローラーとして自然な順序のアクセスが依然として大半を占めており、クロールしていたのはトップページだけでなく、AI・LLMO関連の記事や不動産などの業種別ページといったテーマ性のある個別コンテンツでした。これは「サイト全体を機械的になめている」というより、「特定のテーマの情報を探しに来ている」動きに近く、Bytespiderの大量アクセスとは明らかに性質が異なります。
つまり実態は、「PerplexityBot・OAI-SearchBotは安全、GPTBot・ClaudeBotは要注意」という単純な二分法ではなく、どのAIクローラー名であっても、一定割合はなりすましたスキャンツールが混ざっているという、より厳しい前提で向き合う必要があるということです。名前だけで判断せず、アクセス全体の傾向で読み解く姿勢が欠かせません。
この事実は、それでもなおAI検索エンジン側が自社サイトの個別記事の存在を認識し、内容を読みに来ていることを裏付けています。次の疑問は、「では、そこまで読みに来てもらえた記事は、実際にAIの回答の中で紹介されているのか」です。
「クロールされている」と「引用される」は別問題だった
ここがLLMO対策を判断するうえで最も重要なポイントです。結論から言うと、「クロールされている」ことと「AI検索の回答の中で引用・紹介される」ことは、まったく別の問題でした。
今回のログ調査で、PerplexityBotやOAI-SearchBotが自社の記事・業種別ページを個別に読みに来ていることは確認できました。しかし、AIクローラーが記事を取得することと、ChatGPTやPerplexityの回答の中で実際にその記事が出典として引用・紹介されることは、別の仕組みで動いています。クローラーが情報を収集するのは、あくまで回答を生成するための「材料集め」の段階であり、集めた情報の中から何を根拠として提示するかは、各AIサービス側の選定ロジックに委ねられています。つまり「読みに来てもらえている」ことは、記事の存在をAI側が認識するための前提条件にはなりますが、それだけで出典として引用されることまで保証するものではない、というのが実態に近そうです。

この「クロールはされるが引用はされにくい」という状況は、決してBravoWebに限った話ではなさそうです。SEO専門メディア「ミエルカチャンネル」が2026年に公開した解説動画では、AI検索経由のトラフィックは前年比で伸びてはいるものの、サイト全体のオーガニック流入に占める割合は現時点でまだ1%に満たない水準にとどまっており、今後1〜2年でも数%程度にとどまる可能性が高いという見立てが示されています(出典:ミエルカチャンネル「LLMO対策とは?AIに選ばれるためにやるべきこと・やってはいけないこと」)。同動画では、クロール数や表示回数だけでなく、「同じ質問を何度もAIに投げたときに、自社が引用される割合(いわゆるシェアオブモデル)」を継続的に計測する必要性も指摘されており、クロールされているかどうかと、実際にどれだけ引用されているかは、分けて計測すべき別の指標だという考え方は、今回の自社データとも一致します。
つまり、「AIクローラーのアクセス数が増えてきた」というだけでLLMO対策の成果を判断するのは早計で、実際にChatGPTやPerplexityに具体的な質問を投げて、自社の記事が引用・紹介されるかどうかを定期的に確認する作業までセットで行って初めて、効果測定と呼べる状態になります。

中小企業経営者は結局何をすべきか|現実的な結論
ここまでの実測データを踏まえると、中小企業経営者が取るべきスタンスは「過度な期待」でも「過度な悲観」でもなく、次の3点に整理できます。
「AIクローラーの訪問数」を単独のKPIにしない
AIクローラーのアクセス数は、その9割をBytespiderのような、必ずしも自社の引用に直結しない1社のクローラーが占め、さらに残り1割のほぼ全ボット(PerplexityBot・OAI-SearchBotを含む)にも、一定割合で脆弱性スキャンとみられるノイズが混じります。「AIボットからのアクセスが増えた・減った」という数字単体を、LLMO対策の成果を測るKPIとして扱うのは危険です。
引用状況は、実際にAIへ質問を投げて確認する
クロールされているかどうかはサーバーログでしか分かりませんが、引用されているかどうかは、ChatGPT・Perplexity・Geminiなどに自社の事業テーマに関する質問を実際に投げてみないと分かりません。月1回など頻度を決めて、いくつかの想定質問を投げ、自社サイトが引用・紹介されるかをチェックする運用を、アクセスログの確認とセットで行うことをおすすめします。
サーバーの生ログは、レンタルサーバー会社に確認する
多くの中小企業では自社サーバーを持たず、レンタルサーバーやWordPressのホスティングサービスを利用しています。今回のようなアクセスログの確認は、契約しているサーバー会社の管理画面やサポート窓口から取得・依頼できるケースが多いため、まずは「アクセスログを確認する方法があるか」を契約先に問い合わせてみることが、費用をかけずにできる最初の一歩になります。
以下は、今回の調査を踏まえて経営者・Web担当者が最初に確認しておきたい項目です。
LLMO対策の現状把握チェックリスト
- □ 自社サイトのサーバーアクセスログを、レンタルサーバー会社の管理画面等から確認する方法を把握している
- □ 「AIボットのアクセス数」だけでなく、実際にChatGPTやPerplexityへ質問を投げて引用状況を確認したことがある
- □ 業種名・サービス名で検索されそうな質問を、自社視点でいくつかリストアップできている
- □ LLMO対策ツールを契約する前に、無償でできる基本対策(結論を先に書く、FAQを整備する等)に着手済みである
- □
.envや認証情報ファイルなど、既知の危険パスパターンへのアクセスをサーバー側で遮断する設定を検討したことがある

よくある質問(FAQ)
Q1. Bytespiderとは何のボットですか?なぜこんなに多いのですか?
Bytespiderは、TikTokを運営する中国ByteDance社が運用するクローラーです。公表されている情報によれば、自社の生成AIサービス向けにWeb上のコンテンツを収集する目的とされており、ChatGPTやPerplexityのように「検索結果・回答の中で自社サイトを紹介するため」のクローラーとは性質が異なる可能性があります。
Q2. GPTBot・ClaudeBotのアクセスは本当に偽物なのですか?
断定はできません。User-Agent(名乗っている名前)は誰でも自由に書き換えられるため、本物の公式クローラーかどうかは名前だけでは判断できません。今回のログでは、18秒足らずの間に1つのIPアドレスが34種類もの異なるBot名(世界各国のAI企業のクローラー名を含む)を使い分けるなど、通常の公式クローラーとは考えにくい挙動が確認されました。しかもこの傾向はGPTBot・ClaudeBotに限らず、PerplexityBotやOAI-SearchBotなど、ほぼ全てのAIクローラー名で一定割合確認されています。
Q3. 自社サイトのアクセスログはどうやって確認すればいいですか?
多くの場合、契約しているレンタルサーバー会社やホスティングサービスの管理画面から、アクセスログをダウンロード・閲覧できます。管理画面に見当たらない場合は、サポート窓口に「アクセスログを確認する方法はあるか」と問い合わせるのが確実です。
Q4. クロールされていれば、AI検索に引用されると考えていいですか?
いいえ、必ずしもそうとは限りません。今回の調査でも、PerplexityBotやOAI-SearchBotが記事を具体的にクロールしていることは確認できましたが、集めた情報の中から何を出典として提示するかはAIサービス側の選定ロジック次第です。クロールは引用の前提条件ではありますが、それだけでは引用は保証されません。
Q5. 中小企業はAIクローラー対策として何をすればいいですか?
まずは「AIボットのアクセス数」だけをKPIにしないことが大切です。そのうえで、月次などの頻度でChatGPTやPerplexityに実際の質問を投げて引用状況を確認する運用と、結論を先に書く・FAQを整備するといった無償の基本対策を組み合わせるのが、費用をかけずに始められる現実的な一歩です。
Q6. LLMO対策の効果測定は、どんな指標で行うべきですか?
アクセスログによるクロール状況の確認に加えて、同じ質問を複数回AIに投げたときに自社が引用される割合(シェアオブモデルとも呼ばれます)を継続的に記録することが有効です。アクセス数だけでなく、引用される確率そのものを追いかける発想が、AI検索時代の効果測定には必要になります。
BravoWebに無料相談する
LLMO対策をしているつもりだが、本当に効果が出ているのか自分では確認できない
AIクローラーのアクセスログをどう見ればいいのか、専門的すぎてわからない
うちのサイトがAI検索でどう扱われているか、一度きちんと診断してほしい
中小企業・個人事業主様のホームページ制作を
数多く手がけてきた実績をもとに、最適なプランをご提案します。
※ 相談・お見積りは無料です。

- 監修者
- 田邉 文章 Fumiaki Tanabe

 お見積
 ホームページ
